한밭대 연구팀, ‘학문적 사고력’ 평가하는 국제 벤치마크 개발
국립한밭대학교(총장 오용준) 컴퓨터공학과 박천음 교수 연구팀이 거대언어모델(LLM)의 ‘학문적 사고력’을 평가하기 위한 새로운 국제 벤치마크 ‘ScholarBench’를 개발해 주목받고 있다.
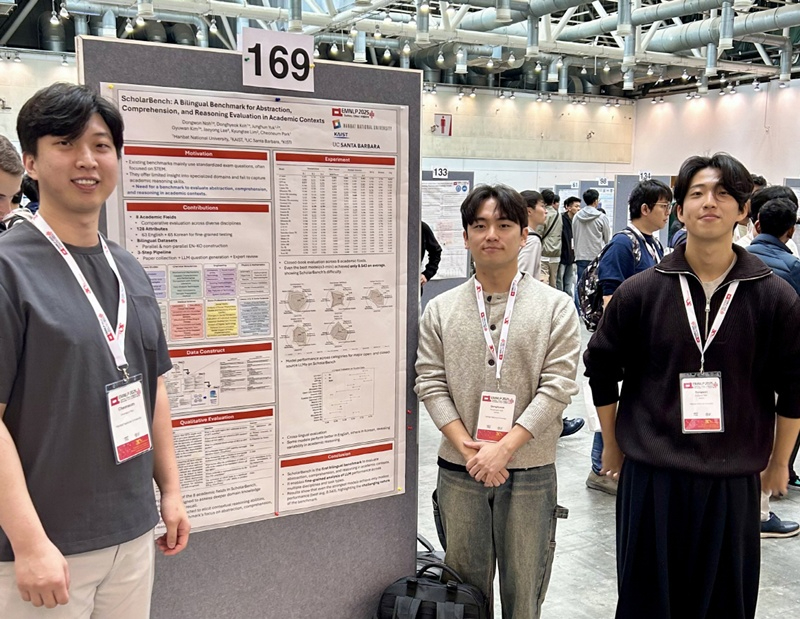
이 연구는 자연어처리 분야 최고 학회 중 하나인 ‘EMNLP 2025’에서 포스터로 발표됐다.
연구에는 노동원 석사과정생과 고동혁 학부생(이상 한밭대), 육정훈 KAIST 문화기술대학원 석사과정생, 김규완 캘리포니아주립대(UCSB) 박사과정생이 공동 제1저자로 참여했으며, 박천음 교수가 교신저자로 연구를 이끌었다.
논문은 *“ScholarBench: A Bilingual Benchmark for Abstraction, Comprehension, and Reasoning Evaluation in Academic Contexts”*라는 제목으로 ACL Anthology(https://aclanthology.org/2025.findings-emnlp.465/)에 공개됐다.
연구팀은 기존의 언어모델 벤치마크들이 주로 문장 완성이나 단순 질의응답, 상식적 추론에 집중되어 ‘학문적 사고의 계층적 구조’를 반영하지 못한다는 한계에 주목했다.
이를 보완하기 위해 ScholarBench는 추상화(Abstraction), 이해(Comprehension), 추론(Reasoning) 등 세 가지 인지 단계를 기준으로 문항을 구성했다.
또한 자연과학, 응용과학, 사회과학, 인문학 등 8개 학문 분야의 실제 논문 텍스트를 반영, 복잡한 개념 관계와 논증 구조를 평가할 수 있도록 설계됐다.
특히 한국어와 영어 두 언어 버전을 동일한 주제와 구조로 제작, 언어 간 사고력의 균형과 학문적 추론의 일관성을 동시에 측정할 수 있는 점이 큰 특징이다.
연구팀이 GPT-4o, Claude-3 등 최신 상용 언어모델을 ScholarBench로 평가한 결과, 학문적 추론 단계에서 평균 0.54점 수준에 그친 것으로 나타났다.
이는 현재의 거대언어모델이 표면적 이해에는 강하지만, 논증 구조나 개념 간 관계를 추론하는 깊은 사고력에는 한계가 있음을 보여준다.
연구진은 “ScholarBench는 단순한 성능 경쟁을 넘어, 모델의 ‘사고 과정’을 분석할 수 있는 평가 틀로서 의미가 크다”고 설명했다.
박천음 교수는 “ScholarBench는 단순한 벤치마크가 아니라, 한국어 학술 데이터를 이해하고 생성할 수 있는 AI 발전 방향을 제시하는 기반”이라며,
“한국 연구자들이 국제적 수준의 AI 평가 생태계에 적극 참여할 수 있도록 기여하겠다”고 밝혔다.
연구팀은 중국 쑤저우에서 열린 EMNLP 2025 학회 포스터 세션에서 ScholarBench의 구조와 설계 원리, 평가 결과를 발표했다.
이번 연구는 ‘AI가 인간처럼 학문을 읽고 사고할 수 있는가’라는 근본적 질문에 대한 실증적 접근으로 평가받고 있으며,특히 한국어를 포함한 최초의 이중언어 학문 추론 벤치마크라는 점에서 학계의 관심을 모으고 있다.
저작권자 © 경충일보 무단전재 및 재배포 금지